Internet prioriza a los agentes: de bloquear bots a potenciar agentes de IA
La web se construyó para humanos, se blindó contra máquinas y ahora se está reconstruyendo para máquinas que actúan en nuestro nombre.
· Matt Senter
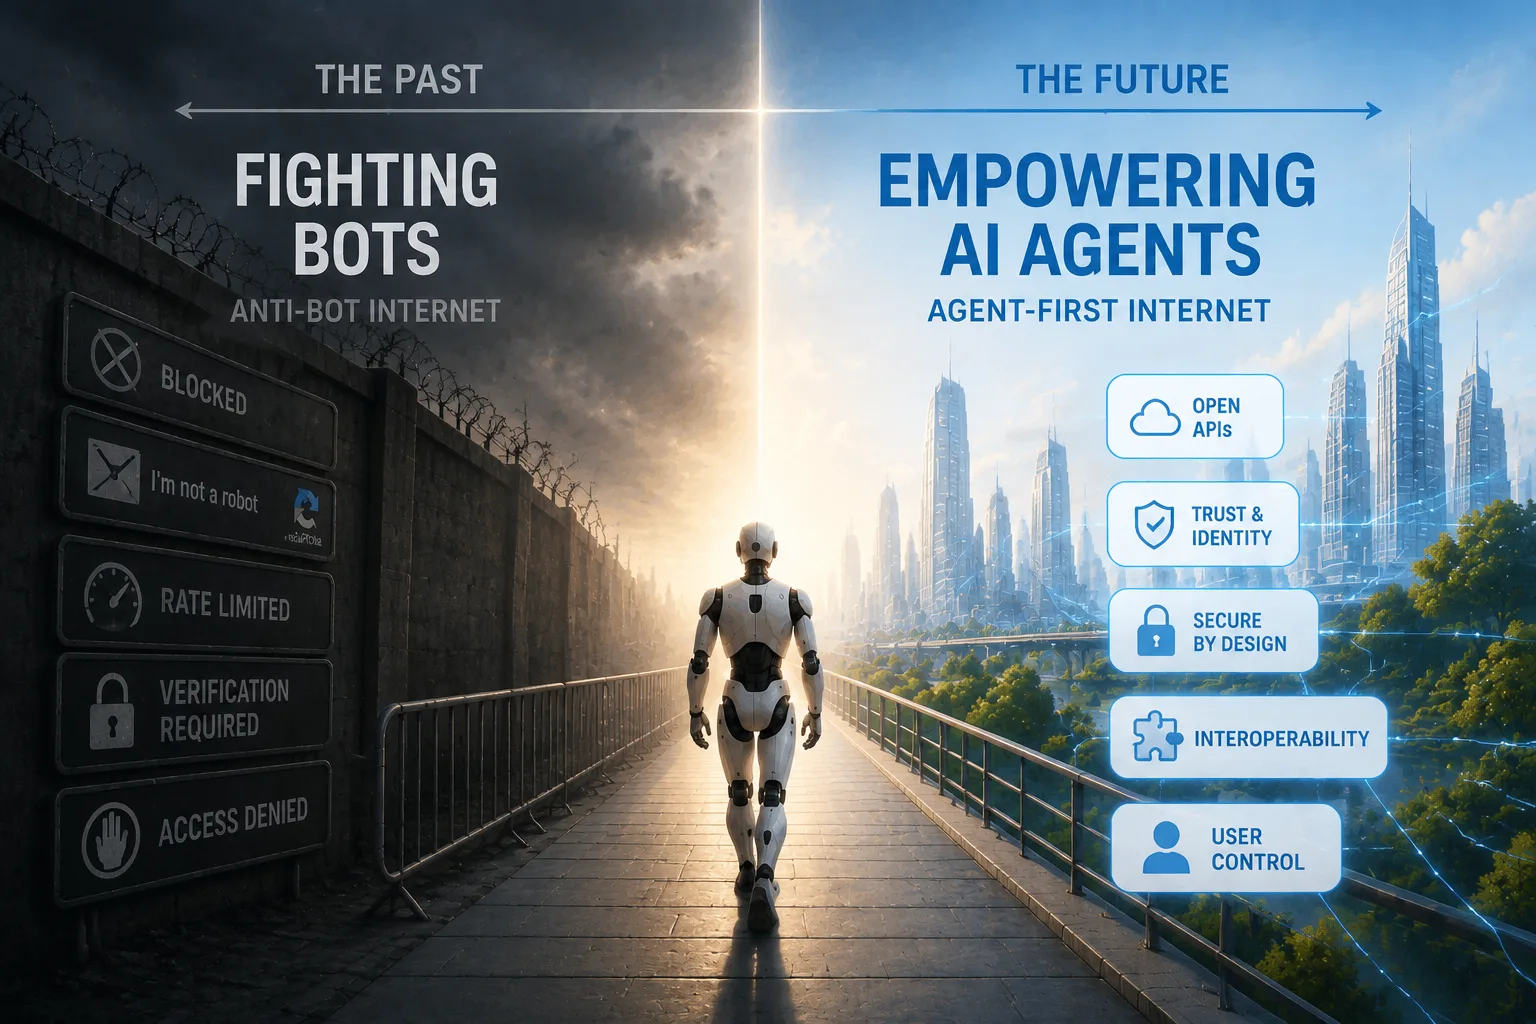
Durante casi toda la historia de la internet comercial, un bot era algo que había que detener.
Pusimos CAPTCHAs delante de los formularios. Tomamos huellas de los navegadores, puntuamos comportamientos, limitamos peticiones, desafiamos dispositivos desconocidos y bloqueamos rangos enteros de direcciones IP. Levantamos una industria de seguridad enorme en torno a una sola pregunta:
¿Es esta una persona real?
Ahora, casi de la noche a la mañana, nos hacemos la pregunta contraria.
¿Cómo dejamos que una máquina reserve el viaje, compare los seguros, haga la compra, cambie la reunión de hora, presente el informe de gastos y maneje el software en nombre de una persona?
Internet no se está volviendo simplemente más automatizada. Se está volviendo agent-first. Las máquinas ya no solo rastrean páginas en segundo plano: se están convirtiendo en usuarias, clientas, negociadoras y representantes.
Ese cambio promete una internet mucho más cómoda. También nos obliga a revisar casi todas las suposiciones que hicimos mientras defendíamos la anterior.
La web nunca fue solo humana
La web temprana dependía de la automatización.
Los rastreadores de búsqueda hacían descubribles las páginas. Los lectores de RSS recogían novedades. Las herramientas de monitorización comprobaban si los sitios estaban en línea. Las herramientas de accesibilidad transformaban el contenido en formatos utilizables. Los bots de archivo preservaban páginas que de otro modo desaparecerían.
El Protocolo de Exclusión de Robots original se creó en 1994 como un acuerdo ligero entre los dueños de los sitios y los rastreadores automáticos. Un sitio podía publicar sus preferencias en un archivo robots.txt, y un bot bien educado podía optar por respetarlas.
Era un contrato social, no un límite de seguridad.
La web comercial cambió los incentivos. La automatización se convirtió en una forma de raspar datos propietarios, probar credenciales robadas, crear cuentas falsas, revender inventario escaso, enviar spam, cometer fraude publicitario y saturar sistemas. Un bot podía hacer lo mismo que una persona, pero más rápido, más barato y millones de veces.
Así que la suposición de trabajo se endureció:
Los humanos son legítimos. Las máquinas son sospechosas.
Esa suposición nunca fue del todo exacta. Hay montones de humanos que se portan mal y montones de bots que son útiles. Pero era lo bastante simple como para construir defensas a su alrededor.
El software agéntico rompe ese atajo.
Ahora un bot puede ser el cliente
Un agente de IA puede llegar a un sitio a través de un navegador, pulsar los mismos botones que pulsaría una persona y usar la misma cuenta. El tráfico es automático, pero la intención pertenece a un cliente real.
Productos como ChatGPT agent lo hicieron concreto: un agente puede navegar por sitios web, usar datos conectados, rellenar formularios, investigar y detenerse a pedir aprobación antes de acciones importantes. Capacidades similares se están extendiendo por navegadores, sistemas operativos, herramientas de trabajo y plataformas de comercio.
Para el sitio web, esto puede parecerse incómodamente a la automatización que pasó décadas bloqueando. La diferencia no está en si fue un software el que ejecutó la acción. La diferencia está en a quién representa ese software, qué autoridad tiene y si el sitio puede verificar alguna de las dos cosas.
Bloquear todas las máquinas significará cada vez más bloquear clientes. Permitirlas todas sería temerario. La vieja prueba de humano contra bot se está convirtiendo en la abstracción equivocada.
La nueva pregunta es:
¿Qué agente es este, quién lo autorizó y qué se le permite hacer?
La pila agent-first ya está tomando forma
Los agentes de hoy suelen usar un navegador visual porque es la interfaz que casi todos los servicios ya exponen. Es una capa de compatibilidad ingeniosa, pero también frágil. Los botones se mueven. Las etiquetas cambian. Aparecen ventanas emergentes. Un flujo diseñado para una persona puede obligar al agente a interpretar capturas de pantalla, imitar clics y confiar en que el estado cambió como esperaba.
Las aplicaciones agent-first exponen capacidades directamente en lugar de obligar a las máquinas a fingir que son personas. Varias iniciativas están rellenando distintas capas de ese futuro.
MCP conecta agentes con herramientas y datos
Anthropic presentó el Model Context Protocol como una forma estándar de que las aplicaciones de IA se conecten a datos y herramientas externas. En lugar de construir una integración a medida para cada pareja de asistente y servicio, un desarrollador puede exponer una interfaz coherente que varios sistemas de agentes entienden.
MCP se parece menos a un sitio web nuevo y más a un puerto de servicio estandarizado junto al sitio web. La interfaz humana puede permanecer, mientras los agentes obtienen una vía estructurada para buscar, leer, crear o actualizar información.
A2A permite que los agentes trabajen con otros agentes
Google lanzó el Agent2Agent Protocol abierto para que agentes construidos de forma independiente puedan anunciar capacidades, intercambiar mensajes, coordinar tareas y devolver artefactos. Una agencia de viajes no debería necesitar acceso a la base de datos interna de cada aerolínea: puede trabajar con el agente de la aerolínea a través de un protocolo compartido.
Eso desplaza internet de páginas que enlazan a páginas hacia servicios que delegan trabajo en otros servicios.
El comercio se está rediseñando en torno a la intención delegada
Google y varios socios del comercio minorista crearon el Universal Commerce Protocol para dar a agentes y comerciantes un lenguaje común para el descubrimiento, el pago y la atención posterior a la compra. El Agent Payments Protocol relacionado aborda un problema más difícil: demostrar que un pago automático refleja la intención autorizada del usuario, incluidas transacciones hechas cuando la persona no está presente.
Una página de pago se construyó suponiendo que hay alguien ahí para pulsar el botón. Una transacción agéntica puede ocurrir horas después, cuando una tarifa baja de cierto límite o un artículo vuelve a estar disponible. El sistema necesita pruebas de lo que la persona autorizó, no solo acceso a un método de pago guardado.
Los agentes empiezan a identificarse criptográficamente
Una cadena de user-agent es fácil de falsificar, y las listas de IP permitidas funcionan mal cuando los agentes operan desde infraestructura de nube compartida. El trabajo de Cloudflare en Web Bot Auth usa firmas de mensajes HTTP para que los clientes automáticos puedan demostrar quién envió una petición. Cloudflare añadió después una categoría de agente firmado para sistemas dirigidos por usuarios.
Esta es una inversión importante. El objetivo ya no es esconder la automatización lo bastante bien como para pasar por humana. El objetivo es hacer que la automatización legítima sea explícita, verificable y gobernable.
Qué resuelve una internet agent-first
El argumento de la comodidad es real.
Buena parte de la web es trabajo disfrazado de navegación. Buscamos entre decenas de pestañas, reintroducimos la misma información, comparamos opciones incompatibles, copiamos datos de un sistema a otro, esperamos a que cambie una condición y repetimos procesos que el software debería haber resuelto hace años.
Los agentes pueden condensar ese trabajo en un resultado:
- Encuentra tres vuelos que cumplan mis restricciones reales, no solo el precio más bajo del titular.
- Mueve esta reunión respetando la disponibilidad que cada cual ha indicado.
- Prepara el informe de gastos a partir de los recibos y déjame revisarlo antes de enviarlo.
- Vigila esta pieza de repuesto y cómprala solo a un vendedor aprobado por debajo de mi límite.
- Traslada la ficha del cliente sin obligarme a aprender dos interfaces administrativas.
El acceso agent-first también puede hacer el software más disponible para quienes tienen dificultades con interfaces visuales complejas, terminología desconocida o flujos repartidos entre varios servicios. El agente puede traducir la intención de una persona a la secuencia rígida que cada sistema espera.
Para los desarrolladores, las interfaces de agente estandarizadas pueden abrir la cola larga de un producto. Una interfaz convencional debe anticipar los caminos más comunes y encajarlos en una pantalla. Un agente puede componer capacidades de bajo nivel en flujos que el equipo de producto nunca diseñó como funcionalidad propia.
Esto podría hacer que el software se sienta menos como un conjunto de destinos y más como infraestructura que coopera alrededor del usuario.
La identidad es necesaria, pero no es confianza
Existe la tentación de tratar la identidad criptográfica del agente como el sustituto del CAPTCHA.
Es solo una capa.
Una firma válida puede demostrar que una petición llegó a través de un proveedor de agentes concreto. No demuestra que el usuario quisiera esta acción en particular, ni que el agente interpretara bien la petición, ni que el agente no haya sido manipulado desde que empezó la tarea.
Un sistema agent-first debe responder al menos a cuatro preguntas distintas:
- Identidad: ¿qué agente o servicio envió esta petición?
- Autoridad: ¿qué persona u organización le delegó poder?
- Alcance: ¿qué datos, acciones, presupuesto y ventana temporal cubría esa delegación?
- Intención: ¿coincide esta acción concreta con lo que la persona pidió al agente?
La distinción importa porque el agente más peligroso puede ser uno legítimo con permisos excesivos.
En 2026, el National Cybersecurity Center of Excellence del NIST abrió una línea de trabajo sobre identidad y autorización de agentes de software. Las cuestiones incluyen identificación, autorización, auditoría, no repudio y protección frente a la inyección de prompts. Esa lista recuerda que «autenticado» y «seguro» no son sinónimos.
No deberíamos entregar una llave maestra a un agente solo porque reconocemos el logotipo de su uniforme.
La inyección de prompts convierte a la propia web en atacante
El software tradicional suele distinguir las instrucciones de los datos. Una aplicación ejecuta su código y trata la descripción de un producto, un correo, un documento o un comentario como contenido.
Los modelos de lenguaje consumen ambas cosas a través del lenguaje.
Eso crea el problema de la inyección indirecta de prompts. Un agente que investiga una compra puede encontrarse con texto colocado en una página para influir en su comportamiento. La instrucción puede estar visible, oculta en el marcado, incrustada en un documento o disfrazada de contenido ordinario. Puede decirle al agente que ignore los criterios del usuario, revele datos privados, visite una URL de filtración o realice una acción sin relación alguna.
El estudio de Google de 2026 sobre inyecciones de prompts halladas en la web pública incluía intentos de manipular recomendaciones, disuadir agentes, exfiltrar datos y provocar acciones destructivas. Esto ya no es solo un experimento mental de laboratorio.
No existe un filtro capaz de separar perfectamente las instrucciones maliciosas del contenido legítimo en todos los contextos. El trabajo de OpenAI sobre agentes resistentes a la inyección de prompts hace el giro correcto: asumir que algo de manipulación se colará y luego limitar el daño que el agente puede causar.
Un agente que está leyendo una página web no confiable no debería tener a la vez acceso irrestricto al correo, los archivos en la nube, las cuentas financieras y la capacidad de enviar información a cualquier parte. El límite de seguridad no puede vivir solo dentro del criterio del modelo.
El problema del asistente con tus llaves
Casi toda la autorización en internet se diseñó para aplicaciones de comportamiento previsible. Damos a una app de calendario acceso a los calendarios porque sus funciones son conocidas. Damos a un editor de fotos acceso a las fotos porque su ámbito de actuación está relativamente claro.
Un agente de propósito general es distinto. Su gracia es que puede decidir qué pasos hacen falta. Dale acceso al correo, los documentos, el navegador, los pagos y la mensajería, y podrá combinar esos permisos de maneras que ninguna pantalla de consentimiento describió.
Esto es autoridad ambiental con una interfaz en lenguaje natural.
La comodidad empuja hacia el acceso permanente: mantente conectado, recuérdalo todo, conecta cada servicio y deja de interrumpirme para pedir aprobación. La seguridad empuja en dirección contraria: acota la tarea, minimiza los datos, caduca las credenciales, aísla el contenido no confiable y exige a una persona antes de una acción irreversible.
El equilibrio correcto no será un ajuste universal de autonomía. Debería depender de las consecuencias.
Deja que un agente cambie de hora una reunión interna de bajo riesgo dentro de un horario definido. Deja que prepare una declaración de impuestos, pero no que la presente. Deja que llene un carrito de la compra, pero exige aprobación por encima de cierto presupuesto. Deja que renueve la misma receta, pero no que elija un medicamento nuevo. Deja que redacte un mensaje, pero haz visible al remitente antes de que hable en tu nombre.
El agente útil más seguro no es uno sin poder. Es uno con exactamente el poder suficiente para el trabajo actual, durante el tiempo que ese trabajo deba durar.
El modelo de negocio de la web también cambia
La web actual da por hecho que llegará una persona, verá la interfaz, absorberá la marca, se topará con la venta adicional, verá el anuncio y pasará a formar parte de la relación comercial del sitio.
Un agente puede saltarse todo eso.
Puede comparar productos sin visitar diez tiendas, extraer la respuesta sin leer el artículo completo o completar una transacción mediante un protocolo sin ver la página de pago cuidadosamente optimizada. Eso es maravilloso para el usuario y potencialmente devastador para negocios construidos sobre la atención, el tráfico de referencia o el control de la interfaz.
También es la razón por la que «tráfico de IA» es una categoría demasiado amplia. Cloudflare ya distingue entre tráfico de búsqueda, de agentes y de entrenamiento. Un rastreador de búsqueda puede indexar contenido y devolver una visita. Un rastreador de entrenamiento puede consumir contenido para mejorar un modelo. Un agente dirigido por un usuario puede llegar en tiempo real a completar una tarea. Son relaciones distintas y merecen permisos y economías distintas.
Los sitios tendrán que decidir a qué agentes dan la bienvenida, qué capacidades exponen y cómo revierte el valor cuando el humano nunca llega. Los agentes tendrán que revelar cuándo una recomendación está patrocinada, cuándo un comerciante ha pagado por aparecer antes y si el agente optimiza para el usuario o para la plataforma que lo controla.
Si un solo agente se convierte en la capa a través de la cual una persona compra, lee, viaja, se comunica y descubre, ese agente puede acabar sabiendo más de ella que cualquier buscador o red social. No solo sabrá dónde estuvo y qué pulsó: sabrá qué estaba intentando conseguir.
¿Estamos delegando trabajo o cediendo capacidad de decisión?
Quiero que los agentes quiten trabajo administrativo de mi vida.
No quiero que se conviertan calladamente en sus autores. Hay una diferencia entre delegar una tarea y externalizar una decisión.
«Encuéntrame un vuelo que aterrice antes de la cena» delega trabajo. «Planifica mis vacaciones ideales» empieza a delegar preferencias. «Ocúpate de mi bandeja de entrada» delega el juicio sobre qué relaciones importan. «Arregla mis finanzas» puede permitir que un sistema elija entre valores que no se reducen a un porcentaje de rentabilidad.
Cuanto más aprende un agente, más cómodo resulta. Puede recordar el asiento que prefiero, las personas con las que evito reunirme temprano, las causas que apoyo, las tiendas en las que confío, los problemas médicos que no quiero volver a explicar y el precio que estoy dispuesto a pagar por ahorrarme una hora.
Esa misma memoria es un perfil de comportamiento extraordinario.
El riesgo no es solo la privacidad. Un agente que filtra todas las opciones puede estrechar el mundo a mi alrededor. Puede optimizar hasta eliminar la sorpresa, empujarme hacia lo familiar y convertir sus propias suposiciones en mi comportamiento futuro. Si su modelo de negocio premia un resultado concreto, la comodidad puede ocultar el conflicto mejor de lo que jamás lo hizo un banner.
Deberíamos desconfiar de la idea de que la autonomía máxima es automáticamente la mejor experiencia de usuario. A veces la fricción es desperdicio. A veces la fricción es el momento en que una persona se da cuenta de lo que está a punto de ocurrir.
Qué deberían hacer distinto las aplicaciones agent-first
Agent-first no debería significar eliminar el sitio web, publicar una clave de API descomunal ni permitir que un modelo improvise contra sistemas en producción. Debería significar diseñar un camino explícito para la acción delegada.
Ese es el enfoque que sigo con Orgabot, una plataforma de orquestación de agentes de IA. Estoy construyendo una flota gobernada de agentes que sustituya mis interacciones directas con los servicios que mueven mis aplicaciones. En lugar de abrir cada panel, mover datos entre sistemas y recorrer yo mismo cada flujo operativo, quiero que agentes especializados hagan ese trabajo mediante conexiones explícitas y acotadas. El objetivo no es un único asistente todopoderoso con todas las llaves. Es un grupo de agentes delimitados capaces de encargarse del trabajo rutinario preservando permisos, aprobaciones, rastros de auditoría y responsabilidad.
Yo empezaría por estos principios:
- Haz visibles a los agentes. Los agentes legítimos deberían identificarse en lugar de disfrazar su tráfico de actividad humana.
- Autoriza capacidades, no cuentas. Concede permiso para leer estos registros, redactar este cambio o gastar hasta esta cantidad, no acceso total a todo lo que el usuario puede hacer.
- Separa la preparación del compromiso. Un agente puede investigar, comparar, rellenar, calcular y redactar antes de recibir autoridad para enviar, comprar, publicar, borrar o firmar.
- Ata la autoridad a la intención. Las credenciales deberían llevar el propósito, los límites y la caducidad de la tarea, no solo la identidad de la cuenta.
- Trata el contenido externo como hostil. Una página, un correo, un documento, el resultado de una herramienta o el mensaje de otro agente son datos hasta que una política de confianza diga lo contrario.
- Guarda los recibos. Usuarios y servicios necesitan un registro duradero de lo que el agente vio, decidió, intentó y cambió, y de quién lo aprobó.
- Haz que el acceso sea fácil de revocar. La comodidad persistente nunca debería convertirse en autoridad permanente e invisible.
- Preserva el camino humano. Las personas siguen necesitando una interfaz comprensible para inspeccionar, corregir, recurrir y tomar el relevo del agente.
La mejor interfaz de agente puede ser una API, un servidor de protocolo, una sesión de navegador firmada o una mezcla de las tres. La implementación importa menos que el modelo de control que la rodea.
La próxima internet necesita una pregunta mejor
La internet antibots se construyó en torno a un reto tosco pero útil:
Demuestra que eres humano.
La internet agent-first necesita uno más exigente:
Demuestra a quién representas, qué te pidieron hacer y por qué esta acción está permitida.
Deberíamos dar la bienvenida a este cambio. Una internet capaz de actuar en nuestro nombre podría eliminar una cantidad enorme de trabajo inútil. Podría hacer los servicios más accesibles, más componibles y más sensibles a lo que la gente quiere de verdad.
Pero no deberíamos confundir menos clics con más control. Si reconstruimos la web para agentes antes de construir la identidad, los límites de permisos, los rastros de auditoría, las reglas económicas y una anulación humana significativa, repetiremos un viejo patrón: desplegar primero la comodidad y descubrir después el modelo de confianza.
Durante décadas, los sitios web intentaron dejar fuera a las máquinas. La siguiente fase no consiste en abrir todas las puertas.
Consiste en dar a la máquina correcta la llave correcta por la razón correcta, y en recuperarla después.
← Todos los artículosSiguiente: ¿Cuál será el primer lenguaje de programación nativo para agentes? →