我正努力说服自己别买 Mac Studio,但 Apple 没有帮忙
· Matt Senter
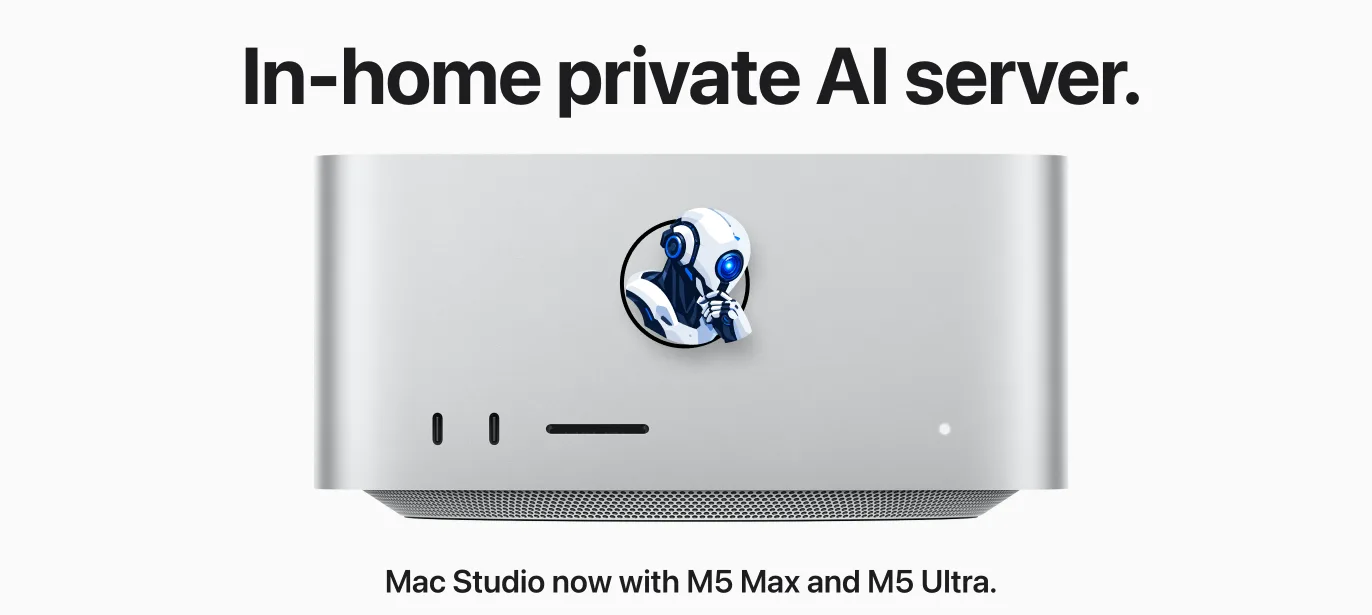
我正试图说服自己:我并不需要一台顶配 Mac Studio。
进展并不顺利。
苹果的新款 Mac Studio 是一台离谱的台式机:最高 512GB 统一内存,1.2TB/s 的内存带宽。更重要的是,苹果明确把它定位成一台端侧 AI 机器,能够在本地运行大型开放权重模型。苹果自己就是这么说的。
我完全不需要这台电脑。大概吧。问题在于,这类机器看上去已经越来越不像台式电脑,而更像一套碰巧摆在桌上的、归个人所有的 AI 基础设施。
苹果几乎是在直白地推销一台私有 AI 服务器
对于这件事的走向,苹果毫不含蓄。它在 Mac mini 的发布稿里,把这台机器描述为适合常开的、放在桌边的智能体计算。Mac Studio 把这个想法推得更远:巨大的统一内存、高带宽,以及通过雷雳 5 把多台机器组成集群来跑超大本地负载的能力。这是苹果的说法,不是我的。
统一内存是其中特别有意思的部分。在 Apple Silicon 上,CPU 和 GPU 共用同一块内存池,而不必在系统内存和独立显存之间来回搬运数据。苹果的开源框架 MLX 正是围绕这一架构设计的。
这并不会让 Mac Studio 神奇地等同于一整个塞满 NVIDIA 硬件的数据中心。但它确实让一台安静的个人电脑拥有数百 GB 可供 GPU 访问的内存成为可能。这改变了这台机器在家里能够合理承担的工作类别。
真正有意思的架构是「本地优先」,而不是「只用本地」
我的论点不是 Mac Studio 能取代 OpenAI、Anthropic 或谷歌。前沿实验室仍将拥有更多算力、更快的发布节奏,以及在大量困难工作上更强的模型。
更有意思的想法是:一层私有的本地智能,负责处理日常工作,把敏感上下文留在家里,只把最棘手的问题上交给前沿模型。
一个编排系统不该只问「哪个模型最聪明」。它应当考虑:这项任务是否敏感、看起来有多难、是否需要代码或视觉能力、多快需要答案、一次外部调用要花多少钱,以及本地模型是否已经够用。
Orgabot 是最清楚的例子
我手上已经有好几个把 AI 放在架构核心的产品:Orgabot、Premail 和 Highwire。Orgabot 是最明显的候选,因为一套编排系统不该跟单一模型绑死。
                         ORGABOT
                            |
          +-----------------+------------------+
          |                 |                  |
          v                 v                  v
      FAST LOCAL       SPECIALIST LOCAL    FRONTIER CLOUD
       MODELS               MODELS              MODELS
          |                 |                  |
     classification      coding             GPT
     extraction          vision             Claude
     summarization       images             Gemini
     embeddings          speech             etc.
          |                 |
          +--------+--------+
                   |
             PRIVATE DATA
             STAYS LOCAL
一个小的本地模型可以做分类、抽取、摘要、路由和生成向量。一个更强的本地编码模型可以处理普通的软件工作。其他本地模型可以专攻视觉、语音或图像生成。真正困难的任务,则可以上交给当时最强的那个前沿模型。
这样一来,选模型这件事就变成了基础设施,而不是用户反复要做的决定。它也让云端成为专家顾问,而不是默认员工。
Premail 提出的是隐私层面的理由
Premail 本来就是 BYOK、隐私优先的。它可以使用用户自己选择的服务商和模型,包括通过 Ollama 提供的本地模型。一台强劲且常开的 Mac,会让这个设计更有说服力。
邮件可以在本地索引、在本地生成向量、在本地分类、在本地摘要,并由一台离你几步远的机器上的模型来处理。日常的草稿和分析根本不必离开家门。
这很重要,因为一个收件箱里装着财务记录、健康信息、家庭对话、账户数据、合同、收据、附件,以及多年的个人历史。AI 邮件助手掌握的上下文越多,它就越有用;但把这些上下文传到别处,后果也就越严重。
在本地优先的设计下,默认值反了过来。原始邮箱留在家里。必要时前沿模型依然可以帮忙,但只带上最低限度的必要上下文。
Highwire 可以把昂贵的推理搬进我家
Highwire 依赖 AI 抓取新闻、把文章聚合成事件与叙事、分析框架与证据,并在读者看到结果之前生成摘要。人们很自然会以为这些工作都该放在云上,因为公开网站就在云上。
但这两件事其实不必绑在一起。
Internet sources
      |
      v
Private AI infrastructure
in my house
      |
      | analysis, classification, embeddings, summarization
      v
Finished structured result
      |
      v
Cloud production environment
      |
      v
highwire.news
公开站点需要可靠的托管、存储、网络和分发。这并不意味着每一项昂贵的推理任务都必须跑在云端数据中心里。一个本地的工作节点完全可以完成大部分分析,然后把结构化结果发布到生产环境。
这里确实有真实的取舍:队列、重试、远程运维、监控、备份,以及一套优雅的云端兜底方案。但这跟从我家里托管一个公开网站不是一回事。一个处理任务晚十分钟,通常是扛得住的。
本地写代码已经相当不错了
本地编码模型里最值得关注的候选之一是 Qwen3-Coder。这一系列就是为智能体式编码和工具驱动的工作流设计的,而那恰恰是我能想象 Orgabot 会交给本地模型去做的活儿。
它不需要在每一项任务上都胜过最好的云端模型。它只需要接下相当大一部分常规工作,而不必把代码仓库送到别人的基础设施上,也不必为生成的每个 token 付费。
但有一点必须说清楚。本地模型在发布节奏、长程推理、工具使用以及从棘手失败中恢复这些方面,可能落后于前沿。当问题含糊、涉及架构,或者格外难缠时,我并不想完全离线。
这是支持「向上升级」的理由,而不是反对本地模型的理由。
前沿模型应该变成一条升级通道
大多数 AI 工作并不需要人类造出的最聪明的那个模型。判断一封邮件是不是收据、抽取一个日期、生成一个向量、总结一段 Git diff、给一篇新闻分类、转写一段音频、看一个简单的日志文件,或者一天之内做出几百个小决定——这些都用不上最新的前沿模型。
Task arrives
    |
    v
Can a local model handle it confidently?
    |
   YES ------------------> Run locally
    |
    NO
    v
Does it contain sensitive information?
    |
   YES
    |
    v
Reduce, sanitize, or preprocess locally
    |
    v
Send minimum necessary context
    |
    v
Frontier model
而当 Orgabot 碰上那个已经扛过三次修复尝试的竞态条件、需要推演一次重大迁移,或者干脆就是信心不足时,它可以去调用前沿模型。这个未来,比假装每台机器都该彻底独立于云端要现实得多。
隐私可能是这么做的最强理由
苹果在保护隐私的云端推理上投入很大,也就是 Private Cloud Compute。工程实现令人佩服。但「造一朵更私密的云」和「压根不把敏感数据送上云」之间,仍然存在架构层面的差别。
最私密的那次云端推理请求,是我从没发出去的那次。
这适用于 Premail,也适用于源代码、内部商业文档、尚未发布的产品、个人文件、凭据,以及一个自主系统能够累积的大量上下文。本地 AI 减少了我必须信任的对象数量。
它并不能消除风险。本地机器同样需要打补丁、加密、备份、隔离和监控。但去掉一次对外的网络请求,就等于去掉了一整类暴露面。
这笔经济账很快就会变得古怪
对于偶尔问问聊天机器人的人来说,买昂贵的本地 AI 硬件在经济上讲不通。云端订阅很方便,而且 GPU 由别人来维护。
但智能体式的负载改变了这个等式。一个持续检查代码仓库、读日志、评估任务、总结信息、监控系统并决定下一步做什么的系统,可能消耗掉惊人数量的 token。本地模型把「再发一次请求」的边际成本,压到接近电费。
它当然也不是免费的。买一台 Mac Studio,等于用资本支出、电力、折旧、存储、维护和终将到来的换机成本,预付了算力。对偶尔的请求来说,云 API 大概率更划算。但对一个持续做成千上万次决策的编排系统而言,自己拥有一部分推理能力,就开始变得有意思多了。
我大概并不需要 512GB 那款
这就是我还在努力克制的地方。对一台个人电脑来说,512GB 的 Mac Studio 是一个近乎滑稽的内存量,而我描述的大多数负载其实用不上那么多。
这个实验的理性版本,大概是一台 128GB 或 256GB 的机器,配上一组精心挑选的模型。非理性版本则是直接上 512GB,因为说不定哪天我就想看看自己能往里塞下多大的模型。
很遗憾,我很清楚在这类内心辩论里,通常是哪个版本的我获胜。
苹果一点忙也没帮上
在生成式 AI 的头几年里,我们是从别人的数据中心里租用智能。而 Mac Studio 这样的机器,指向了另一种未来:在本地拥有足够应付日常工作的智能,只有真正需要时才去租用前沿智能。
如果我把 Mac Studio 当成一台强力台式机,那买顶配就显得很荒唐。可如果我把它当成一套基础设施——能持续运行 Orgabot、私密地处理 Premail 的数据、生成图像、转写音频、驱动编码智能体、帮忙产出 Highwire,并在必要时有选择地调用前沿模型——这笔账就完全是另一个样子了。
这就很不妙了。我当初开始查这些资料,本来就是为了给自己找不买它的理由。